
DataOps y Observabilidad: Cómo prevenir fallos silenciosos en tus bases de datos antes del inicio de la jornada
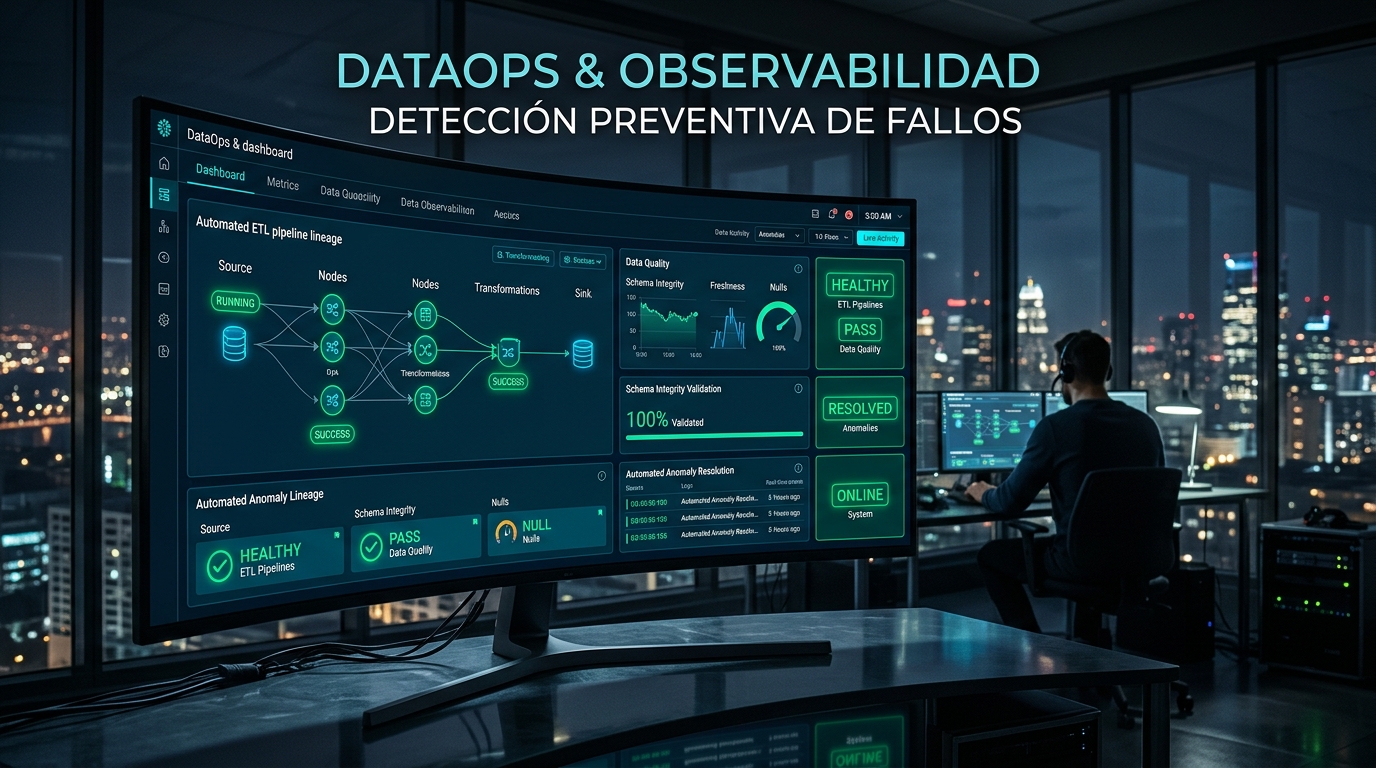
En infraestructura tecnológica, el incidente más temido no es la caída estrepitosa de un servidor con pantallas rojas y alarmas sonando. El escenario verdaderamente destructivo es el fallo silencioso: aquel proceso que se ejecuta aparentemente sin errores, pero cuyos resultados corrompen los datos que alimentan las decisiones estratégicas de la empresa.
1. La anatomía de un fallo silencioso
Considere este caso habitual en empresas con arquitecturas tradicionales:
Durante la tarde, un proveedor actualiza una versión del software ERP y modifica sutilmente el nombre de una columna (por ejemplo, de monto_neto a monto_subtotal) o introduce un valor nulo en un campo antes obligatorio. A las 02:00 AM, el pipeline automatizado de extracción corre su rutina habitual.
Como no existe una capa de observabilidad que valide esquemas, el script no se interrumpe: simplemente omite los registros alterados o rellena los campos con ceros. El proceso finaliza con código de salida exitoso. A las 09:00 AM, el comité directivo abre su tablero de control y observa una inexplicable contracción del 40% en las ventas de la semana. La desconfianza en los reportes queda sembrada de inmediato.
2. La diferencia entre monitoreo tradicional y DataOps
El monitoreo de infraestructura tradicional (uptime, CPU, uso de memoria) solo indica si la máquina virtual está encendida. No dice nada sobre la calidad de los datos que viajan por sus tuberías.
DataOps traslada las mejores prácticas de DevOps y control de calidad de software al ciclo de vida de los datos mediante tres controles automatizados:
1. Pruebas de Integridad de Esquema (Schema Tests)
Antes de inyectar datos al almacén final, el pipeline valida automáticamente que los tipos de datos, nombres de columnas y formatos requeridos no hayan sufrido modificaciones inesperadas en los sistemas de origen.
2. Detección de Anomalías de Volumen y Frescura
Si una sucursal suele registrar mil transacciones diarias y una noche ingresan solo treinta, los algoritmos de observabilidad detectan la anomalía estadística de forma temprana y generan una alerta preventiva.
3. Alertas Proactivas antes de las 08:00 AM
El equipo de ingeniería recibe la notificación de incidencia en la madrugada, permitiendo aislar la causa raíz, aplicar la corrección y reejecutar la carga antes de que el equipo directivo inicie su jornada laboral.
3. De la reacción caótica al gobierno proactivo
Implementar pipelines sin observabilidad equivale a operar una red corporativa sin cortafuegos: tarde o temprano fallará y el costo será reputacional. En InSideOn estructuramos soluciones de datos donde la supervisión y las alertas automáticas forman parte nativa de la arquitectura, garantizando que cada cifra consultada por la gerencia sea 100% confiable y auditable.
¿Cómo reacciona su empresa ante fallos en los flujos de datos?
Conversemos sobre cómo implementar observabilidad y monitoreo continuo sobre sus bases de datos para anticipar incidentes antes de que afecten a su directiva.
Conversar por WhatsApp